نخست مرتب‌ کنید (tidy first) (۲)

  • یوسف مهرداد بی‌بالان

در مورد مرتب‌سازی (tidying)

سوال اصلی این است: “من می خواهم کدی را تغییر بدهم ولی ساختار کد به گونه‌ای است که تغییر آن دشوار است. آیا ابتدا باید کد را مرتب کنم؟” بِک ادامه می‌دهد “من در مورد بازسازی‌ (refactor) کدهای بزرگ صحبت نمی‌کنم. من در مورد تقسیم کدهای بزرگ و یک‌تکه به مایکروسرویس‌ها(microservice) و تصمیم‌های بزرگ و باشکوه در مقیاس بزرگ صحبت نمی‌کنم. من در مورد رابطه‌‌ی خودم با خودم صحبت می‌کنم. آیا برای خودم این ارزش قائل هستم که کارم را راحت‌تر کنم؟”با این اوصاف، برنامه نویسی نباید کاری اضطراب آور، دلهره‌آور و اعتماد به نفس خراب‌کن باشد. در نتیجه، قبول یک مساله‌ی پیچیده و شکستن آن به مساله‌های کوچکتر که درک آنها آسان‌تر است، عادت بی‌نهایت مفیدی است. او می‌گوید”اصطلاحی است که تقریباً ده سال پیش آن را پیشنهاد کردم: – MCETMEC تغییر را آسان کنید و بعد تغییر آسان را انجام دهید (Make the Change Easy Then Make the Easy Change).آسان کردن تغییر، قلمروی اصلی طراحی نرم افزار است. بنابراین به جای اینکه بخش‌های سخت و پیچیده را تغییر دهید که برای انجام آن هم مجبورید به صورت همزمان 100 جای سیستم را تغییر دهید، می‌توانید ابتدا کدها را مرتب کنید، هزینه ایجاد همه آن تغییرات را کم کنید و سپس یک تغییر آسان را انجام دهید.”

در توسعه نرم‌افزار، زمانی‌که از یک ایده (مثلا”من به یک دکمه در سیستم برای ویرایش اطلاعات نیاز دارم”) به تغییر(UX، گردش‌ کار و بک‌اند (backend) پشت آن) می رسیم، رفتار سیستم یعنی ویژگی‌های قابل مشاهده بیرونی آن -را تغییر می‌کنیم. تغییر در رفتار برنامه معمولا باعث ایجاد چرخه‌ای می‌شود که در آن، پیاده‌سازی هر ویژگی جدید باعث تولید مثل و تولد ویژگی‌های جدیدتری می‌شود. از سوی دیگر یک مسیر موازی و پنهان نیز وجود دارد که بخش ساختاری نرم‌افزار است (شبیه به کوه یخی که قسمت‌هایی از آن در زیر آب پنهان است). یکی از نکات زیبا و قشنگ در اینجا این است که ساختار نیز به‌تنهایی می‌تواند برای کارهای قابل انجام در سیستم، ایده‌‌هایی را پیشنهاد کند. و اگر بتوانید تمام این حلقه‌های بازخورد را با هم اجرا کنید، می‌توانید به سرعت کشف کنید که چگونه نرم‌افزار شما می‌تواند ارزش بیشتری خلق کند.

در چنین شرایطی ممکن است اختلالاتی هم رخ دهد. برخی از سبک‌های توسعه (development styles) روی حلقه “ایده → رفتار → ایده” تمرکز می کنند که باعث می‌شود دور باطلی ) از پیاده سازی ویژگی‌ها بدون توجه به ساختار سیستم ایجاد گردد. (مترجم؛ چرخ همستر یا دور باطل به فعالیتی گفته می‌شود که با انجام آن، شخص همیشه مشغول است اما هرگز به دستاورد مهم و ارزشمندی دست پیدا نمی‌کند و از سوی دیگر پایانی نیز برای آن فعالیت وجود ندارد.)

یکی دیگر از اختلالات، زمانی رخ می‌دهد که قبل از هر گونه پیاده‌سازی، تمام تلاش‌ها صرف تهیه‌ی یک طراحی کامل و بی‌نقص می‌شود (طراحی بزرگِ قبل از پیاده‌سازی، سلام! (Big Design Upfront)) در پی این تلاش‌ها، ساختارهای زیبا و خوش ساخت زیادی ایجاد می‌شوند در حالی که هیچ کاربرد و اهمیتی در پیاده‌سازی رفتارهای مورد نیاز کاربران ندارند. این روش سرمایه‌گذاری روی ساختارها، شما نه‌تنها بازده و منفعتی از سرمایه‌گذاری خود کسب نمی‌کنید بلکه بازخوردها را نیز به تاخیر می‌اندازید.

کنت بک طرفدار و مدافع این موضوع است که یک تکرار ( iteration) سریع باید در تمام حلقه‌های بازخورد بالا وجود داشته باشد. شما باید بتوانید ایده‌ها را به سرعت امتحان کنید، ساختار را به شکلی که برای رفتار جدید مناسب‌تر است تغییر دهید و سپس تغییر رفتار را کامل کنید و به پایان برسانید (گاهی تغییرات طراحی باعث پیشنهاد شدن ایده‌های جدیدی برای سیستم می‌گردد و شما را به مسیر جدیدی هدایت می کند). توانایی انجام این تغییرات در قالب بخش‌ها و تکه‌های کوچک است که ارزشی فوق العاده‌ خلق می‌کند. (مترجم؛ کنت بک اعتقاد دارد پروژه‌ها باید به صورت بخش‌ها و تکه‌های کوچک انجام شوند و درست مانند رانندگی روی یخ، ذره ذره پیش رفت.)

گزیده:
پیشنهاد می‌کنم ۱۰ تا ۲۰ درصد از کل زمان توسعه خود را صرف سرمایه‌گذاری [روی برنامه‌نویسی استراتژیک] کنید. این زمان آن قدر کم است که تأثیر چندانی بر برنامه‌‌ریزی‌ها ندارد، اما آن قدر بزرگ است که بتواند به مرور و در طول زمان، نتایج قابل‌توجهی به بار آورد.»
از کتاب فلسفه طراحی نرم افزار نوشته‌ی جان اوسترهات،

Agile Software Development for Developers

  • یوسف مهرداد بی‌بالان

در ابتدای سال ۲۰۲۰ که کووید همه‌گیر شده بود و همه از دانشگاه‌ها و شرکت‌ها به خانه‌ها نقل مکان کرده بودیم، به پیشنهاد و همراهی دوست عزیزم آقا رضای رحمتی و کوشش‌های دوست عزیزم محمد آقای نادی، دوره‌ی «متدهای چابک برای توسعه‌دهندگان نرم‌افزار» را برای کانون برنامه‌نویسان ایرانی مقیم کانادا برگزار کردم.
برای این دوره، بخش‌هایی از متدهای چابک را انتخاب کردم که به گمانم بیشتر مورد استفاده برنامه‌نویسان و توسعه‌دهندگان قرار می‌گیرد. دوره‌ی بسیار جالبی بود؛ هم از این بابت که اولین بار بود که در بسترهای ارتباطی آنلاین دوره‌ای برگزار می‌کردم و هم اینکه مخاطبان دوره، عزیزانی از شرق، مرکز و غرب کانادا بودند.
ویدیوهای این دوره در یوتیوب در دسترس همگان قرار دارد و می‌توانید از طریق آدرس‌های زیر به آنها دسترسی داشته باشید.
در پایان جا دارد از کمک‌های عزیزان و سروران گرامی‌ام آقایان و خانم‌ها، فائزه اشراق، رضا مقدس جعفری، حسین نصیری، رضا رحمتی و محمد نادی برای برگزاری این دوره تشکر و قدردانی نمایم.


Session 1: Agile Software Development in a Nutshell and Cynefin (https://youtu.be/yZLfrMTez4g)
Session 2: Scrum Overview and Product Backlog (https://youtu.be/sJ7V8xgJTv4)
Session 3: Estimation (Part 1) (https://youtu.be/mq_fJ3EjfQE)
Session 4: Estimation (Part 2) (https://youtu.be/TgAJcGHU-C4)
Session 5: Velocity and Release Planning (https://youtu.be/kQypG2RL3lk)
Session 6: Sprint Planning.(https://youtu.be/RBHWDv60Nno)
Session 7: Sprint Execution (https://youtu.be/GtZdiybHJQQ)

گزیده:
«اندازهٔ واقعی آموزش‌یافتگی تو، آن چیزی نیست که می‌دانی، بلکه این است که چطور دانسته‌هایت را با دیگران سهیم شوی.» کنت نربرن

نخست مرتب‌ کنید (tidy first) (۱)

  • یوسف مهرداد بی‌بالان

پیش‌گفتار:
مدت‌هاست که می‌خواستم درباره‌ی Tidy First (با تلفظ تایدی) مطلبی بنویسم و این نگرش زیبا و جالب‌توجه را به دوستان عزیزم و خوانندگان وبلاگ معرفی کنم. با این‌که مدت‌هاست آن را دنبال می‌کنم ولی بخت و اقبال در راه ترجمه‌ی آن با من یار نبود. خوش اقبال بودم که حمید آقای عزیزم کمک کرد تا این خواسته جامه‌ی عمل پوشانده شود. با سپاس از ایشان،‌ از شما دعوت می‌کنم که این سری از نوشته‌ها را دنبال نمایید.

گفتار:
کنت بک (Kent Beck) مهندس نرم‌افزار و متولد آمریکا است، او خالق اکس پی (xp یا Extreme Programming )، سخنران اصلی و الهام‌بخش بسیاری از گردهمایی‌ها و کسی است که توسعه‌ی آزمون محور ( TDD یا Test-Driven Development) را دوباره کشف و متحول کرد.

بیت‌روت (Beetroot) مفتخر است که آقای بک، سخنران مهمان یکی از رویدادهای رایگان تک‌تاک‌پلاس (#TechTalk) است. با الهام از دیدگاه او درباره‌ طراحی نرم‌افزار و از آنجا که بهبود مداوم کیفیت توسعه نرم‌افزار در خون ماست، تصمیم گرفتیم برخی از نکات کلیدی صحبت‌های او در این رویداد را با شما در میان بگذاریم. حتما در وبلاگ کنت عضو شوید تا فصل‌های جدید کتاب او را دریافت کنید.

در مورد طراحی نرم افزار
“طراحی نرم افزار فعالیتی در حوزه‌ی روابط انسانی است”. این اولین خطی بود که کنت بک برای عنوان سخنرانی‌اش با عنوان”نخست‌ مرتب‌ کنید (Tidy First) چیست؟”- نوشت. در نگاه اول، توسعه نرم افزار ارتباط چندانی با روابط اجتماعی ندارد و درباره‌ی جفت‌شدگی (coupling)، چسبندگی(cohesion)، قانون توان(power law)، بازسازی (refactoring) و غیره و در یک کلام،‌ درباره‌ی کد است. آیا واقعا طراحی نرم‌افزار ارتباطی با روابط انسانی ندارد؟ با مشاهده طراحی نرم افزار از دریچه‌ی روابط انسانی می‌توان دامنه‌ی بررسی را کوچک‌ کرد و به بررسی تعاملات بین افراد فنی (افراد متخصص یا geek) و افراد غیر فنی (غیر متخصص یا non-geeks) پرداخت.

در شکل زیر، دایره بیرونی مرزی است بین چیزهایی که تحت کنترل افراد فنی است و چیزهایی که تحت کنترل آنها نیست. بِک آنها را “پیشخدمت‌ها” (waiters) و “تغییردهنده‌ها” (changers) می‌نامد. پیشخدمت‌ها درخواست می‌کنند تا در رفتار سیستم تغییری ایجاد شود، در حالی که تغییر کد عملا با تغییردهنده‌ها است. رابطه بین این دو دسته می‌تواند پرتنش باشد، به ویژه زمانی که دو طرف یکدیگر را درک نمی‌کنند. در داخل دایره، مجموعه‌ متفاوتی از روابط وجود دارد؛ در یک تیم نرم افزاری، توسعه‌دهندگان پیوسته با تصمیم‌های خود در طراحی نرم افزار، روی یکدیگر تاثیر می‌گذارند.

نوع سوم رابطه، رابطه هر برنامه نویس با خودش است (برای همین صورتک خندان در وسط دایره قرار دارد). رابطه نامناسب با خودمان باعث می‌شود بارها و بارها کارهای سخت و دشوار را با ابزارهای کند و نامناسب انجام دهیم یا API های بد و نامناسب را تحمل کنیم و با آنها سر و کله بزنیم. به جای چنین‌ کارهایی باید بالاترین اولویت را به رابطه با خودمان اختصاص دهیم و بعد بقیه روابط را به صورت چشمگیری بهبود دهیم. کنت بک می گوید: «تا زمانی که به عنوان یک برنامه نویس با خودم رابطه سالمی نداشته باشم، احتمالاً نمی‌توانم حتی با سایر برنامه نویسان هم روابط سالمی داشته باشم. و این پایه و اساسِ موضوعی است که امروز درباره آن صحبت می‌کنیم، و همین‌طور موضوع کتابی است که مشغول نوشتن آن هستم.» (مترجم: به گفته‌ی جولی هنکس ارتباط سالم با خود (A healthy self-relationship) به معنای توانایی ارزش قائل شدن برای خود به‌عنوان یک انسان و پذیرش نقاط قوت و ضعف خود است.)

مترجم: حمید خاتمی
گزیده:‌
“مشکل دنیا این است که افراد باهوش پر از شک و تردید‌ند، در حالی که احمق‌ها پر از اعتماد به نفس‌اند.” چارلز بوکوفسکی

یادگیری ماشین برای همه (۸)

  • یوسف مهرداد بی‌بالان

ادامه طبقه‌بندی …

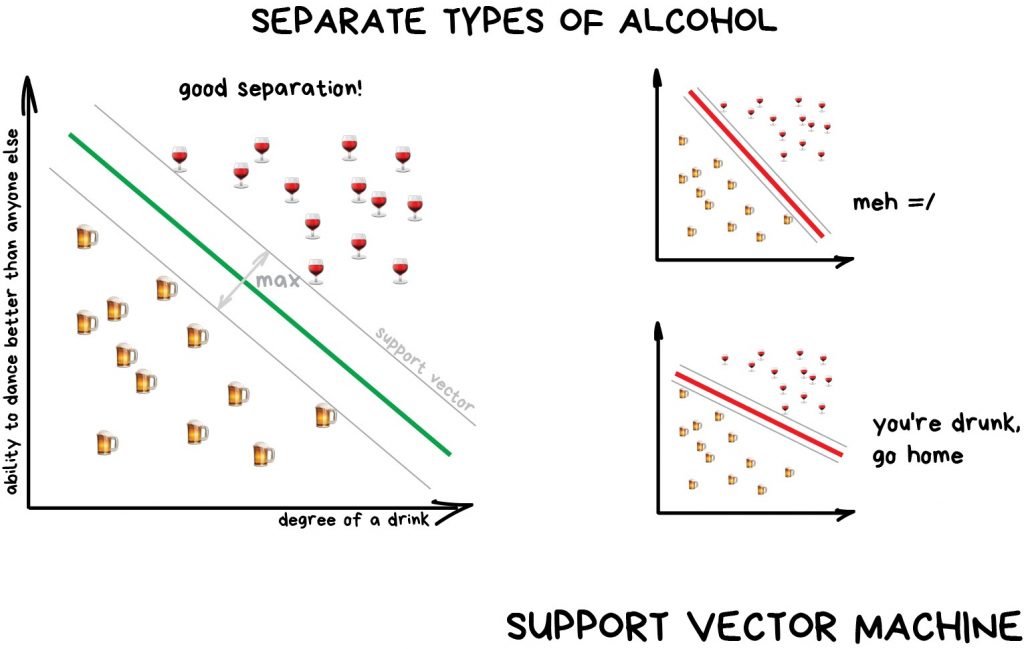
ماشین‌ بردار پشتیبان (Support Vector Machines) یا SVM به راستی محبوب‌ترین روش طبقه‌بندی کلاسیک است. از آن برای طبقه‌بندی هر موجودی در جهان هستی استفاده می‌شود مانند طبقه‌بندی گیاهان بر اساس شکل ظاهری آنها در عکس‌ یا طبقه‌بندی اسناد بر اساس نوع آنها و…

ایده‌ی پشت SVM بسیار ساده است. SVM سعی می‌کند تا دو خط با بیشترین فاصله‌ی ممکن بین نقاط داده (data points) ترسیم کند. به تصویر زیر نگاه کنید.

یکی از کاربردهای جنبی و بسیار مفید طبقه‌بندی، تشخیص ناهنجاری (anomaly detection) است. هنگامی که یکی از ویژگی‌های داده در هیچ یک از طبقه‌ها قرار نمی‌گیرد(مترجم؛ مثلا در دسته‌بندی عکس‌ها به عکس سگ و عکس گربه،‌ عکسی از فیل وجود داشته باشد)، آن را برجسته و اعلام می‌کنیم. این روزها از تشخیص ناهنجاری در پزشکی و برای تصاویر MRI استفاده می‌شود. رایانه‌ها تمام مناطق مشکوک به بیماری یا متفاوت با حالت عادی آزمایش را برجسته و گزارش می‌کنند. بازارهای سهام از این تکنیک برای شناسایی رفتار غیرعادی معامله‌گران و پیدا کردن معامله‌گرانی که به صورت غیرقانونی به اطلاعات محرمانه‌ی شرکت‌ها دسترسی دارند استفاده می‌کنند. در اینجا، وقتی می‌خواهیم داده‌های درست را به کامپیوتر آموزش بدهیم در واقع داده‌هایی را به آن آموزش می‌دهیم که در واقع اشتباه و نادرست‌اند (مترجم؛ ما تصاویر پزشکی با علائم غیرعادی و مشکوک به بیماری و هم‌چنین اطلاعات معامله‌گران قانون‌گریز را به ماشین یاد می‌دهیم تا آنها را شناسایی کند).

امروزه معمولا برای طبقه‌بندی، بیشتر از شبکه‌های عصبی (neural networks) استفاده می‌شود. در حقیقت شبکه‌های عصبی اصلا برای همین کار به وجود آمده‌اند.

قاعده کلی (rule of thumb) این است: هر چه داده‌ها پیچیده‌تر، الگوریتم هم پیچیده‌تر. برای داده‌های متنی، عددی و جدولی، من روش‌های کلاسیک را انتخاب می‌کنم. زیرا در روش‌های کلاسیک، مدل‌ها کوچکترند و سریع‌تر یاد می‌گیرند و البته عملکرد آنها شفاف‌تر و قابل‌فهم‌تر است. برای تصاویر ، فیلم و بقیه کلان داده‌های (big data) پیچیده، من قطعاً شبکه‌های عصبی را انتخاب می‌کنم.

تا پنج سال پیش هم می‌شد یک طبقه‌‌بندی‌کننده (classifier) برای دسته‌بندی چهره‌های انسان پیدا کرد که با SVM ساخته شده باشد. اما امروزه برای انجام چنین کاری، راه آسان‌تر این است که از بین صدها شبکه‌ی عصبی‌ که از پیش آموزش دیده‌اند (pre-trained) یکی را انتخاب کنید. اما روش‌های به‌کار رفته در فیلترکننده‌های هرزنامه‌ها (spam filters) هیچ تغییری نکرده‌اند و کماکان با SVM نوشته می‌شوند. و تاکنون هیچ دلیل منطقی و مناسبی برای تغییر آنها پیدا نشده است.
حتی وب سایت شخصی من نیز برای شناسایی هرزنامه‌ها در بخش نظرات (comeents) از SVM استفاده می‌کند. ¯_(ツ)_/¯

مترجم: خانم سپیده مشایخی

گزیده:
از دید من، یادگیری ماشین ابزاری است برای رساندن ما از داده‌ها به احتمالات. اما برای رسیدن از احتمالات به درک واقعی، هنوز دو گام دیگر باید برداشته شود- دو گام بزرگ و مهم. یکی پیش‌بینی اثر اقدامات و دیگری تصور خلاف وابع

جودیا پرل (Judea Pearl)
منبع: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی

بیجار

  • یوسف مهرداد بی‌بالان

به سفر می روم و بسته به دل مهر وطن
رشته‌ای از پی باز آمدنم چون ماکو

نعمت هند فراوان بود، اما نرود
یاد گیلان ز دل و حسرت نان لاکو

سلیم تهرانی

عکس: بیجار (مزرعه‌ برنج) در بی‌بالان
عکس از مهدی مهرداد

پانوشت:
نان لاکو؛ نانی رایج در گیلان

برنامه ۱۲ عاملی (۹)- عامل هشتم: همروندی

  • یوسف مهرداد بی‌بالان

عامل ۸- همروندی (Concurrency)
برنامه را از طریق مدل پردازش (process model) مقیاس‌پذیر و بزرگ کنید

هر برنامه کامپیوتری پس از اجرا با یک یا چند پردازش (process) در سیستم عامل نمایش داده می‌شود. برنامه‌های وب شکل‌های مختلفی برای اجرای پردازش پیدا کرده‌اند. به عنوان مثال پردازش‌ها یا برنامه‌های PHP می‌توانند به عنوان فرزندی از پردازش‌های آپاچی اجرا می‌شوند البته در صورت نیاز (on demand) و بسته به میزان حجم درخواست (request). پردازش‌های جاوا رویکردی متضادی دارند، این رویکرد به کمک JVM و ابتدا با استفاده از پردازش غول‌پیکری که بخش بزرگی از منابع سیستم مانند CPU و حافظه را در ابتدا در اختیار می‌گیرد و سپس با مدیریت داخلی همروندی (concurrency) به کمک ریسمان‌ها(thread) انجام می‌شود. در هر دو نمونه یعنی PHP و جاوا، امکانِ دسترسی و مشاهده‌‌ی پردازش‌های در حال اجرا برای توسعه‌دهندگان برنامه در پایین‌ترین میزان خود قرار دارد.

پردازش‌ها در برنامه دوازده عاملی اهمیت زیادی دارند و شهروندان درجه‌ یک به حساب می‌آیند. (مترجم؛ در زبان‌های برنامه نویسی، شهروند درجه یک عنصری از زبان است که از تمام عملیات موجود که برای سایر عناصر زبان پشتیبانی می‌کند). خط مشی پردازش‌ها در برنامه دوازده عاملی به شدت از مدل پردازش یونیکس (unix) برای دیمن‌های (deamon) سرویس‌های در حال اجرا اقتباس شده است. (مترجم؛ دیمن، پردازشی از نوع سرویس (service process) که در پس‌زمینه (background) اجرا می‌شود و وظیفه‌ی آن نظارت و رسیدگی به سیستم یا فراهم‌سازی خدماتی برای سایر پردازش‌هاست). توسعه‌دهندگان به کمک این مدل می‌توانند معماری برنامه خود را برای مدیریت اجرای کارهای متنوع و متفاوت به گونه‌ای طراحی کنند که هر نوعی از کارها را به یک نوع پردازش (process type) ویژه‌ محول کنند. به عنوان نمونه، درخواست‌های HTTP توسط یک پردازش وب (web process) مدیریت می‌شود و کاری که در پس‌زمنیه برای طولانی‌مدت باید اجرا شود توسط یک پردازش کارگر(worker process) انجام می‌شود.

چنین رویکردی در مورد تقسیم زمان و تسهیم منابع (multiplexing) داخلیِ پردازش‌های مستقل استثنا قائل نمی‌شود. (مترجم؛ ایجاد منابع متعدد منطقی از یک منبع فیزیکی را مالتی پلکس گویند) . این کار معمولا به کمک ریسمان‌های (thread) داخل ماشین مجازی (VM) یا به کمک مدل async/evented که در ابزارهایی مانند EventMachine، Twisted یا Node.js وجود دارند مدیریت می‌شوند. نکته مهم این است که اندازه‌ی ماشین مجازی می‌تواند تا حد مشخصی افزایش یابد (افزایش عمودی)، بنابراین برنامه باید بتواند با چندین پردازش که روی چندین ماشین فیزیکی در حال اجرا هستند نیز کار کند.

وقتی که زمان مقیاس‌پذیری افقی (scale out) فرا برسد تازه اهمیت مدل پردازش نمایان می‌شود (مترجم؛ scale in به معنای افزایش عمودی منابع و scale out به معنای افزایش افقی آنها است.). اصل «اشتراک‌گذاری صفر»(share-nothing) و ماهیت تقسیم‌پذیری افقیِ پردازش‌های برنامه دوازده عاملی به این معنی است که افزایش همروندی (concurrency) عملیاتی ساده و قابل اتکا است. آرایه ای از نوع پردازش (Process type) و تعداد پردازش‌های موجود از هر نوع با نام شکل گیری پردازش (process formation) شناخته می‌شود.

پردازش‌‌ها در برنامه دوازده عاملی هرگز نباید دیمن‌سازی کنند (daemonize) یا فایل‌های PID (process identifier) را دست کاری کنند (مترجم؛ دیمن‌سازی یک برنامه یا اسکریپت به معنای آماده‌سازی آنها برای اجرا در پس‌زمینه (background) و تبدیل کردن آنها به یک دیمن است).. در عوض، برای مدیریت خروجی‌ها، رسیدگی به پردازش‌های از کار افتاده و مدیریت راه‌اندازی‌های مجدد و خاموش‌ کردن‌هایی که توسط کاربر انجام می‌شوند، باید از مدیریت پردازش‌های سیستم عامل استفاده کنند. از جمله‌ی این ابزارهای مدیریت پردازش‌ می‌توان به systemd در لینوکس، مدیر پردازش توزیع‌شده در پلتفرم‌های ابری یا ابزارهایی که برای توسعه‌دهندگان ساخته‌ شده‌اند مانند Foreman اشاره کرد.

نوشته‌های قبلی:
قسمت هشتم: عامل هفتم: اتصال به پورت

مترجم: حمید آقای خاتمی

گزیده:
«از اژدهای هفت‌سر مترس، از مردم نمام بترس که هرچه وی به ساعتی بشکافد، به سالی نتوان دوخت.» قابوسنامه

یادگیری ماشین برای همه (۷)

  • یوسف مهرداد بی‌بالان

ادامه طبقه‌بندی …

بیایید نمونه‌ی عملی دیگری از طبقه‌بندی را با هم بررسی کنیم. فرض کنید شما می‌خواهید مبلغی از بانک وام یا اعتبار بگیرید. چگونه بانک تشخیص می‌دهد که شما وام‌ را بازپرداخت خواهید کرد یا نه؟ قطعا هيچ راهی برای کسب اطمینان صد در صدی وجود ندارد. اما بانک پرونده تعداد زیادی از مشتریان را دارد که قبلا وام گرفته‌اند. بانک اطلاعات مربوط به سن، تحصیلات، شغل و حقوق و مهم‌تر از همه این‌که وام را بازپرداخت کرده‌اند یا خیر را دارد.
با استفاده از این داده‌ها می‌توانیم روش یافتن الگوها (pattern) و پیدا کردن پاسخ این سوال را به ماشین آموزش دهیم. در اینجا مشکل خاصی برای پیدا کردن پاسخ وجود ندارد. موضوع اصلی این است که بانک نمی‌تواند کورکورانه به پاسخ ماشین اعتماد کند. زیرا ممکن است خرابی سیستم (system failure) یا حمله هکرها اتفاق افتاده باشد یا حتی ممکن است کارمند سالخورده‌ای که در وضعیت سرخوشی (drunk) است با راهکار سریع‌اش برای رفع خطا (quick fix) باعث خرابی سیستم شده باشد.
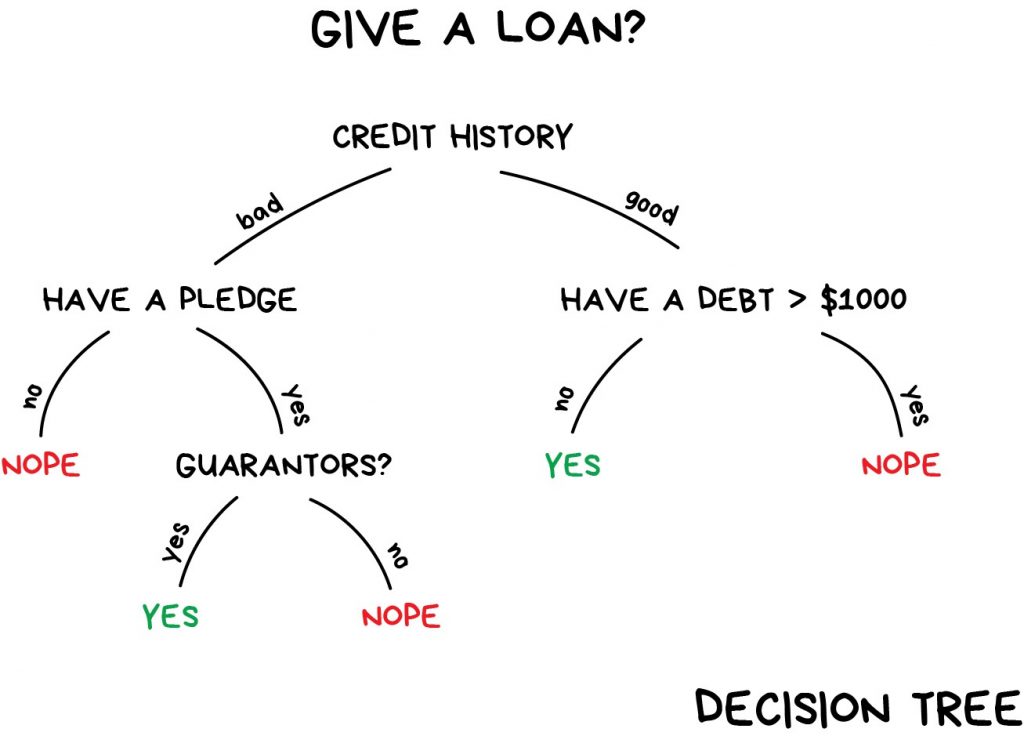
برای حل این گونه مسائل از درخت تصمیم (Decision Tree) استفاده می‌شود (اینجا را هم ببیند https://bit.ly/3PZNLRl ).
تمام داده‌ها به صورت خودکار به سوالات بله/خیر تقسیم می‌شوند برای مثال «آیا درآمد وام‌گیرنده بیش از ۱۲۸.۱۲ دلار است؟». چنین کاری ‌می‌تواند از نگاه انسان‌ها کمی عجیب به نظر برسد. با این حال، ماشین چنین سوالاتی را مطرح می‌کند تا داده‌ها را در هر گام به بهترین شکل تقسیم کند.


با این روش، درخت تصمیم ساخته می‌شود. هرچه ارتفاع درخت بیشتر باشد (مترجم؛ به شکل نگاه کنید) به این معناست که سوال‌ها گسترده‌تر هستند. هر تحلیلگری می‌تواند درخت را ببیند و آن را توضیح دهد. ممکن است منطق آن را درک نکند اما به راحتی می‌تواند آن را توضیح دهد! (منظور من تحلیل‌گرهای معمولی‌اند)
درخت‌ تصمیم به طور گسترده‌ای در حوزه‌های پرمسئولیتی مانند تشخیص بیماری، پزشکی و امور مالی استفاده می‌شوند.
امروزه به ندرت از درخت تصمیم به تنهایی و بدون ترکیب با سایر تکنیک‌ها استفاده می‌شود. با این حال، آنها معمولا پایه و اساس سیستم‌های بزرگ را تشکیل می‌دهند و ترکیب گروهی از آنها حتی بهتر از شبکه‌های عصبی کار می‌کند. بعداً در این مورد صحبت خواهیم کرد.
وقتی عبارتی را در گوگل جستجو می‌کنید دقیقا گروهی درخت تصمیم وجود دارند که دنبال طیف وسیعی از پاسخ‌ها می‌گردند. موتورهای جستجو به دلیل سرعت بالا، عاشق درخت‌‌های تصمیم هستند.
دو مورد از الگوریتم‌های معروف برای ساختن درخت CART و C4.5 هستند.

مترجم: خانم سپیده مشایخی

گزیده:
من به تازگی از توماسو پوجیو، یکی از پیشگامان علم عصب‌شناسی مدرن، پرسیدم که آیا نگران نیست که رایانه‌ها با قدرت پردازشی فزاینده‌ای که دارند به زودی بتوانند به تقلید از کارکرد مغز انسان بپردازند؟ او پاسخ داد: هیچ بختی ندارند.

ست لوید (Seth Lloyd)
منبع: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی


برای خروج از جستجو کلید ESC را بفشارید